فرصت مطالعه ندارید؟ چکیده این مطلب را همینجا گوش دهید:
مدل هوش مصنوعی DeepSeek V4.1 Flash (نسخه ۱۷ اکتبر ۲۰۲۶) به عنوان یک مدل ترکیبی تنک (Sparse Mixture-of-Experts) معرفی شده است که با ساختار معماری نوین Causal Encoder-Decoder یا همان CED توانسته توجه بسیاری از توسعهدهندگان را به خود جلب کند. این مدل با هدف ارائه بالاترین کارایی در وظایف پیچیده، کدنویسی و کارهای نیازمند زمینه طولانی (Long-context) با هزینهای بسیار پایین طراحی شده است.
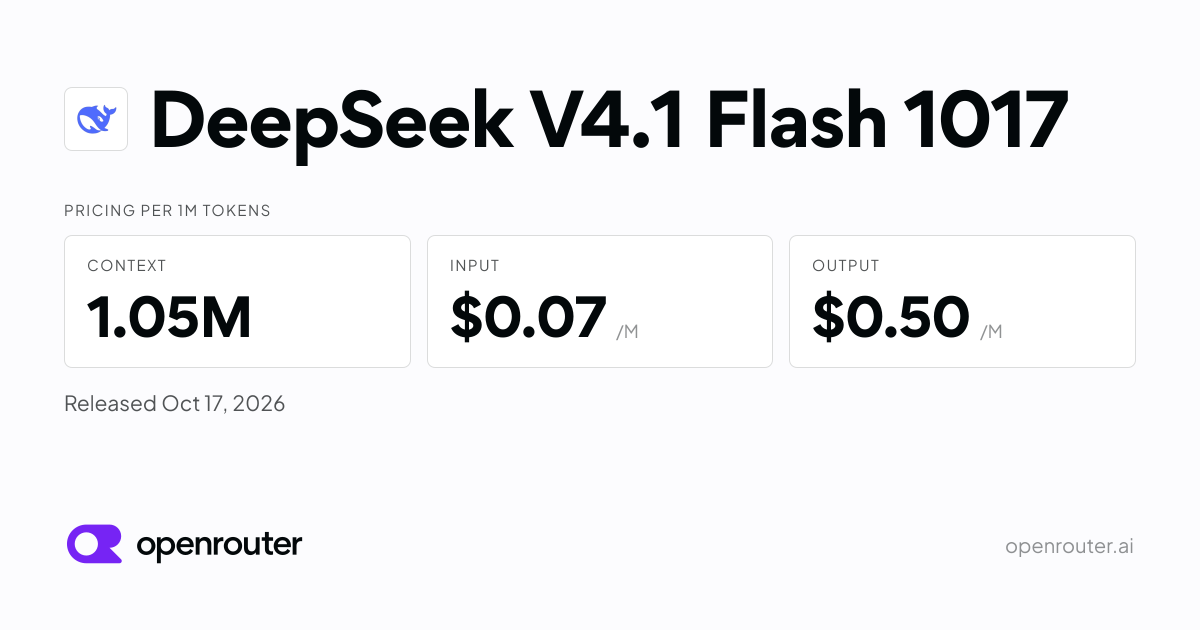
معماری و مشخصات فنی DeepSeek V4.1 Flash
این مدل بر پایه یک بکبون غولپیکر ۵۵۲ میلیارد پارامتری توسعه یافته است، اما نکته جذاب در ساختار آن این است که در هنگام ورودی فقط ۸ میلیارد پارامتر و در هنگام خروجی ۱۶ میلیارد پارامتر را فعال میکند. این تقسیمبندی نامتقارن باعث میشود که میزان محاسبات به ازای هر توکن (Per-token compute) نسبت به اندازه کل مدل در پایینترین حد ممکن نگه داشته شود. این رویکرد شباهتهای مفهومی زیادی با روشهای بهینهسازی دارد که در ابزارهای پیشرفته توسعه نرمافزار مانند بررسی کورسر (Cursor)؛ دستیار هوش مصنوعی پیشرفته برای برنامهنویسی برای افزایش سرعت پاسخگویی استفاده میشوند.
بر خلاف نسخههای آزمایشی قبلی که قابلیت بینایی (Vision) به صورت الحاقی به آنها اضافه میشد، در این نسخه درک تصویر به صورت بومی (Native) در معماری گنجانده شده است. این یعنی امبدینگهای بصری و متنی از همان ابتدای پیشآموزش به صورت مشترک آموزش دیدهاند.
| ویژگی | مقدار / مشخصات |
|---|---|
| نام مدل در API | deepseek-flash |
| معماری | Sparse MoE با پایه CED |
| پارامترهای فعال | ۸ میلیارد ورودی / ۱۶ میلیارد خروجی (از کل ۵۵۲ میلیارد) |
| پنجره زمینه (Context Window) | ۱ میلیون توکن |
| قیمت ورودی / خروجی | ۰.۰۷ دلار برای ورودی / ۰.۵۰ دلار برای خروجی به ازای هر ۱ میلیون توکن |
| تاریخ انتشار | ۱۷ اکتبر ۲۰۲۶ |
| وضعیت دسترسی برای ایران | دارای محدودیت منطقهای |
کاربردهای اصلی و سناریوهای استفاده
با توجه به ویژگیهای ساختاری ذکر شده، این مدل گزینهای ایدهآل برای حوزههای خاصی از مهندسی نرمافزار و پردازش داده به شمار میرود:
- ایجنتهای کدنویسی و ترمینال: مناسب برای ابزارهایی که نیاز به اجرای خودکار دستورات، خواندن کدهای پایگاه داده و تعامل مستقیم با محیط کامپیوتر دارند.
- وظایف طولانیمدت (Long-horizon tasks): پروژههایی که باید در طی مراحل طولانی و بدون خطا تا انتها اجرا شوند.
- تحلیل متنهای طولانی: پشتیبانی از پنجره زمینه ۱ میلیون توکنی امکان بررسی فایلهای بزرگ متنی یا مستندات فنی حجیم را فراهم میکند.
- پردازش تصویر و متن همزمان: به دلیل درک بومی تصاویر، برای تحلیل اسناد گرافیکی، نمودارها و اسکرینشاتها کاربرد عالی دارد.
ساختار کشینگ فشرده و بهینهسازی هزینه
یکی از بزرگترین مشکلات در کار با ایجنتهای هوش مصنوعی، مصرف بالای حافظه کش و هزینههای سرسامآور آن است. در این نسخه، تکنولوژی فشردهسازی KV Caching توانسته حجم حافظه کش را به حدود یک چهارم نسل قبلی Flash کاهش دهد. این نوآوری فنی نقش بسیار مهمی در کاهش چشمگیر هزینهها در بارهای کاری مبتنی بر ایجنت (Agentic workloads) ایفا میکند.
طبق بنچمارکهای منتشر شده، این مدل در تستهای معتبری مانند GPQA Diamond و TAU-Bench امتیازات بسیار بالایی (بالای ۹۰ درصد در برخی ارائهدهندگان) کسب کرده و سرعت پردازش آن در برخی پرووایدرها به بیش از ۲۳۰ توکن بر ثانیه رسیده است.
پرسشهای متداول
آیا DeepSeek V4.1 Flash رایگان است؟
خیر، این مدل از طریق API و پلتفرمهای واسط ارائه میشود، اما هزینه استفاده از آن بسیار پایین است (۷ سنت به ازای هر میلیون توکن ورودی و ۵۰ سنت برای خروجی).
تفاوت اصلی این مدل با نسخههای قبلی چیست؟
استفاده از معماری نوین CED، ادغام بومی قابلیت بینایی از ابتدا، و فشردهسازی پیشرفته KV Caching برای کاهش مصرف حافظه و هزینه.
حجم پنجره زمینه (Context Window) چقدر است؟
این مدل از پنجره زمینه ۱ میلیون توکنی پشتیبانی میکند که برای پردازش مستندات بسیار حجیم و کدهای طولانی کاملاً مناسب است.
جمعبندی
مدل DeepSeek V4.1 Flash با ترکیب معماری نوین CED، پارامترهای فعال بهینه، کشینگ فشرده KV و هزینه بسیار پایین API، گامی بزرگ در جهت مقرونبهصرفه کردن ایجنتهای هوش مصنوعی و ابزارهای توسعه نرمافزار به حساب میآید. اگر به دنبال پردازش حجم عظیمی از دادهها، کدها یا تصاویر با سرعت بالا و هزینه کم هستید، بررسی و بهکارگیری این مدل از طریق پلتفرمهای ارائهدهنده میتواند بهرهوری پروژههای شما را به شکل محسوسی افزایش دهد.



