فرصت مطالعه ندارید؟ چکیده این مطلب را همینجا گوش دهید:
ورود به دنیای هوش مصنوعی و مدلهای زبان بزرگ (LLM) نیازمند یک نقشه راه ساختاریافته است که از مباحث پایه ریاضی و پایتون شروع شده و تا پیادهسازی و استقرار برنامههای پیشرفته ادامه پیدا کند. پروژهی متنباز LLM Course دقیقاً همین مسیر جامع را به صورت کاملاً رایگان در اختیار برنامهنویسان و علاقهمندان قرار میدهد. این مخزن با ارائهی دستورالعملهای دقیق، مقالات کاربردی و نوتبوکهای اجرایی گوگل کولب، به شما کمک میکند تا از سطح مبتدی تا متخصص مهندسی مدلهای زبانی رشد کنید.
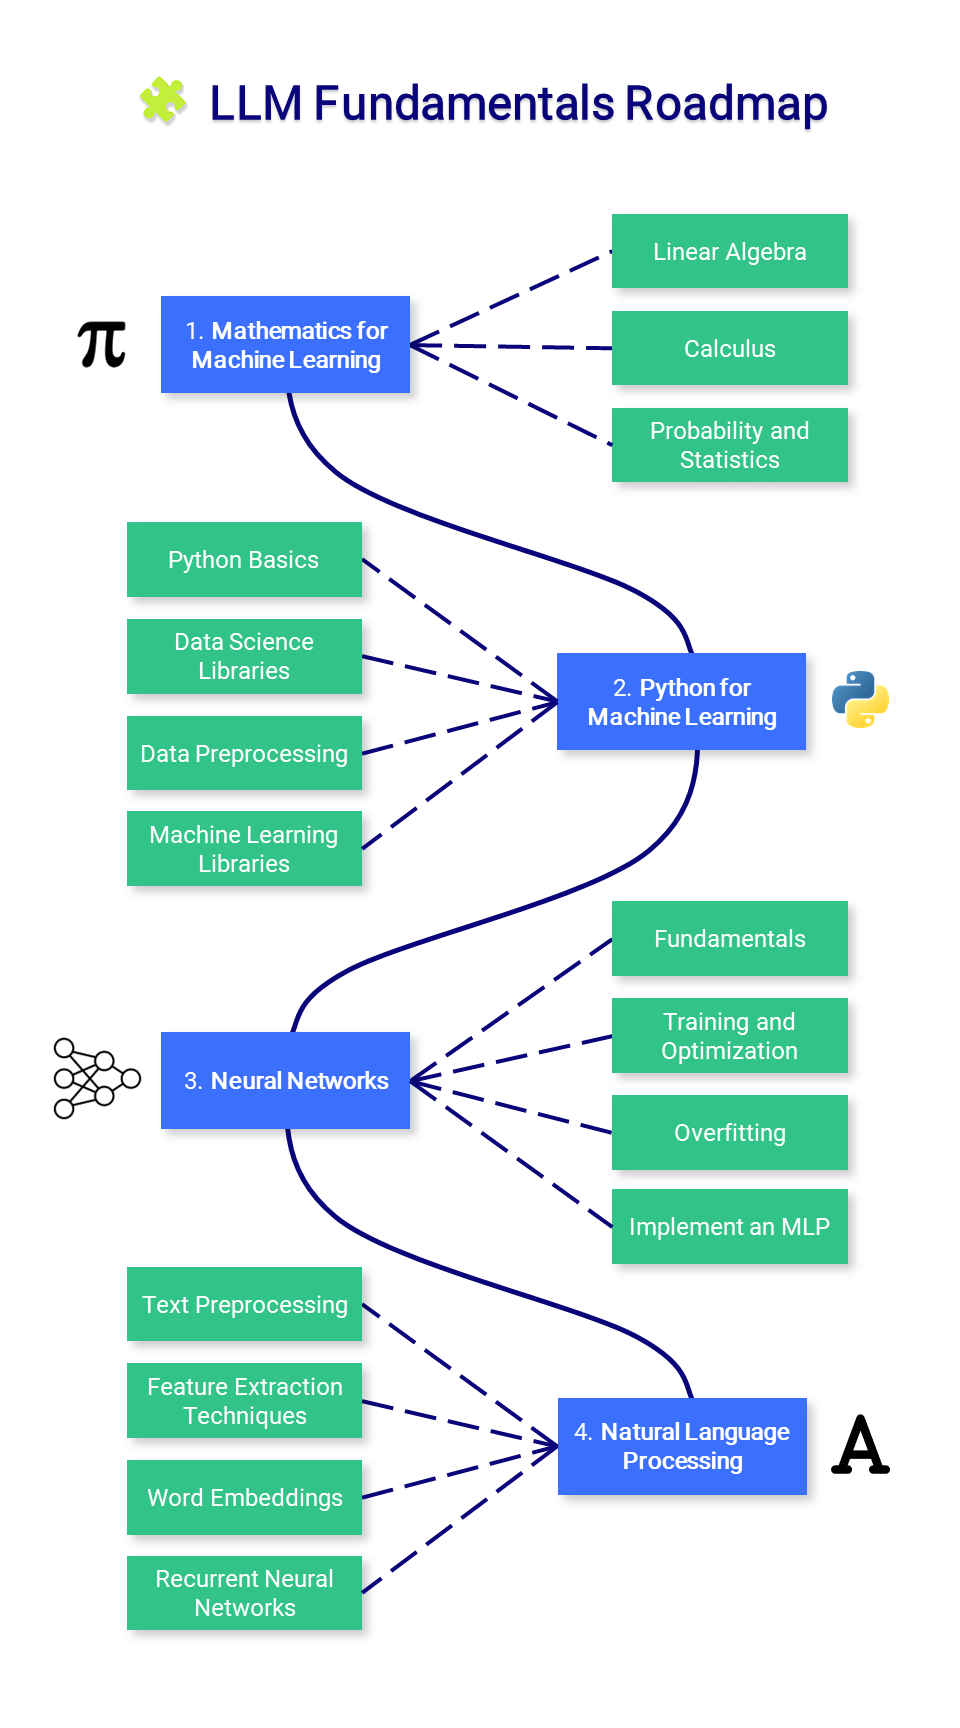
ساختار کلی نقشه راه و بخشهای آموزشی
این دوره به سه بخش اصلی تقسیم شده است که هر کدام روی جنبه خاصی از هوش مصنوعی تمرکز دارند. علاوه بر این، ابزارهای مدیریت داده و ایجنتهای هوش مصنوعی مانند آنچه در معرفی Orca؛ ابزار متنباز مدیریت و اجرای همزمان ایجنتهای هوش مصنوعی بررسی شد، نقش مکمل مهمی در ساخت برنامهها دارند:
- مبانی هوش مصنوعی (LLM Fundamentals): بخش اختیاری اما ضروری که دانش پایه در زمینه ریاضیات، جبر خطی، حسابان، آمار، برنامهنویسی پایتون و شبکههای عصبی را پوشش میدهد.
- دانشمند مدلهای زبانی (The LLM Scientist): تمرکز روی ساخت و بهبود مدلها با استفاده از آخرین تکنیکهای روز مانند تنظیم دقیق (Fine-tuning) و بهینهسازی.
- مهندس مدلهای زبانی (The LLM Engineer): تمرکز روی ساخت برنامههای کاربردی مبتنی بر LLM و استقرار آنها در محیط واقعی.
| ویژگی | مقدار / مشخصات |
|---|---|
| نوع پروژه | مخزن آموزشی متنباز (Open Source Course) |
| مجوز (License) | Apache-2.0 |
| زبان برنامهنویسی | پایتون (Python) / نوتبوکهای گوگل کولب |
| وضعیت دسترسی ایران | کاملاً قابل دسترس (Accessible) |
| هزینه | ۱۰۰٪ رایگان |
نوتبوکها و ابزارهای کاربردی همراه دوره
این مخزن شامل ابزارها و اسکریپتهای آمادهای است که فرآیند کار با مدلها را به شدت ساده میکنند. برای مثال، برای پردازش و ساخت خروجیهای ساختاریافته یا تحلیل دادههای متنی، گاهی نیاز به ابزارهای کمکی دارید؛ مشابه فرآیندی که در آموزش تبدیل دادههای اکسل به گزارش و ارائه جذاب با هوش مصنوعی Bricks برای دادههای ساختاریافته دیدهایم. برخی از ابزارهای مهم معرفیشده در این دوره عبارتند از:
- LazyMergekit: ادغام آسان مدلها با استفاده از MergeKit تنها با یک کلیک.
- LazyAxolotl: تنظیم دقیق مدلها در کلود با استفاده از Axolotl.
- AutoQuant: کمیتسازی (Quantization) مدلها در فرمتهای GGUF، GPTQ، EXL2، AWQ و HQQ.
- ZeroSpace: ایجاد خودکار رابط کاربری چت Gradio با استفاده از منابع رایگان.
آشنایی با مبانی پایتون و یادگیری ماشین
برای شروع کار با کتابخانههای هوش مصنوعی، تسلط بر ابزارهای تحلیل داده در پایتون ضروری است. در بخش مبانی دوره، یادگیری کتابخانههایی مانند NumPy و Pandas برای دستکاری دادهها، و Scikit-learn برای الگوریتمهای کلاسیک یادگیری ماشین آموزش داده میشود. در ادامه یک نمونه کد پایتون برای کار با ساختارهای داده و پردازش اولیه آورده شده است:
import numpy as np
import pandas as pd
# ایجاد یک مجموعه داده نمونه برای تمرین پیشپردازش دادهها
data = {
'سن': [25, 30, 35, 40, None],
'حقوق': [50000, 65000, 80000, 110000, 75000],
'وضعیت': ['فعال', 'غیرفعال', 'فعال', 'فعال', 'غیرفعال']
}
# تبدیل دیکشنری به دیتافریم پانداس
df = pd.DataFrame(data)
# پر کردن مقادیر گمشده در ستون سن با میانگین
mean_age = df['سن'].mean()
df['سن'] = df['سن'].fillna(mean_age)
print("دیتافریم پس از پاکسازی:")
print(df)
توضیح بخشهای کد بالا به این صورت است که ابتدا کتابخانههای پانداس و نامپی فراخوانی میشوند. سپس یک دیکشنری حاوی دادههای فرضی که شامل یک مقدار گمشده (None) است ساخته میشود. با استفاده از تابع fillna، مقدار میانگین سن جایگزین مقدار خالی میشود تا دادهها برای ورود به مدلهای یادگیری ماشین آماده گردند.
تنظیم دقیق (Fine-tuning) و بهینهسازی مدلها
یکی از بخشهای جذاب این دوره، آموزش گامبهگام تنظیم دقیق مدلهای پیشرفته مانند Llama و Mistral با استفاده از روشهای کممصرف مانند QLoRA و کتابخانههای کارآمد است. کدهای مربوط به این بخش معمولاً در محیط گوگل کولب اجرا میشوند تا نیاز به کارت گرافیک گرانقیمت نداشته باشید.
پرسشهای متداول
آیا استفاده از این دوره نیازی به پرداخت هزینه دارد؟
خیر، تمامی محتوا، نوتبوکها و نقشههای راه این مخزن ۱۰۰٪ رایگان هستند و همیشه رایگان باقی خواهند ماند.
برای شروع این دوره چه میزان تسلط به پایتون نیاز است؟
آشنایی پایه با سینتکس پایتون، توابع و ساختارهای داده برای شروع کافی است. بخش اول دوره نیز مبانی پایتون و کتابخانههای دادهای را مرور میکند.
آیا برای اجرای نوتبوکها حتماً به سیستم قوی نیاز دارم؟
خیر، بیشتر نوتبوکهای این دوره روی گوگل کولب (Google Colab) پیادهسازی شدهاند که امکان اجرای کدها روی سرورهای ابری را فراهم میکند.
جمعبندی
مخزن LLM Course یکی از کاملترین، بهروزترین و ساختاریافتهترین منابع رایگان برای ورود به دنیای مدلهای زبان بزرگ و هوش مصنوعی است. چه بخواهید مبانی ریاضی و یادگیری ماشین را یاد بگیرید و چه قصد داشته باشید مدلهای پیشرفته را شخصیسازی و پیادهسازی کنید، این دوره تمام ابزارها و کدهای لازم را در اختیار شما میگذارد.



