فرصت مطالعه ندارید؟ چکیده این مطلب را همینجا گوش دهید:
مدلهای زبانی بزرگ و پیشرفتهای که امروزه میشناسیم در بسیاری از حوزهها شگفتانگیز ظاهر شدهاند، اما آیا میتوان به آنها برای کارهای حساسی مانند تشخیص پزشکی هم اعتماد کرد؟ یک متخصص پوست با انجام آزمایشی روی ۲۰۰ ضایعه پوستی تأییدشده با نمونهبرداری، عملکرد مدلهای زبانی پیشرفته مانند GPT-6 Astra و Claude Fable 5.1 را با یک شبکه عصبی کانولوشنال (CNN) قدیمی و ده ساله به نام Inception v3 مقایسه کرده است. نتیجه این آزمایش بسیار غافلگیرکننده بود؛ ابزاری که یک دهه پیش توسط گوگل توسعه یافته بود، توانست با دقت بالاتری نسبت به مدلهای زبانی روز دنیا ضایعات بدخیم را تشخیص دهد.
در این مقاله به بررسی جزئیات این آزمایش، نحوه عملکرد ابزارها، محدودیتها و شیوه استفاده از نسخه مرورگر این شبکه عصبی میپردازیم. اگر به ابزارهای تحلیل داده و فناوریهای نوین پزشکی علاقه دارید، شاید این مطلب درست مانند استفاده از ابزارهای کمکی دیگر مثل سمنติก اسکالر (Semantic Scholar)؛ موتور جستجوی هوشمند مقالات علمی برایتان الهامبخش باشد.
جزئیات آزمایش و جامعه آماری ضایعات پوستی
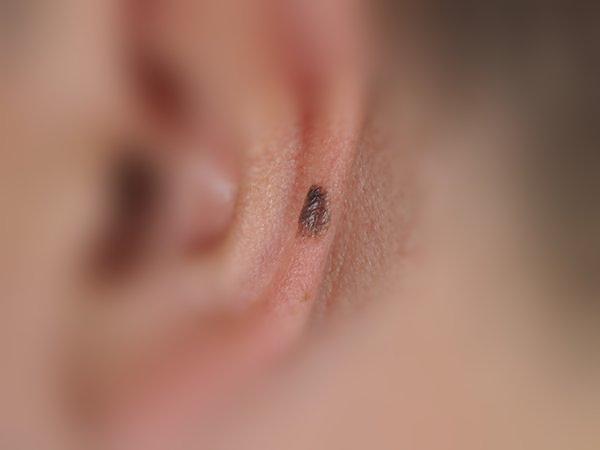
این پژوهش بر روی ۲۰۰ ضایعه پوستی انتخابشده بهصورت تصادفی از مجموعه داده عمومی MILK10k (منتشر شده در سال ۲۰۲۵ توسط همکاری بینالمللی تصویربرداری پوست یا همان ISIC) انجام شده است. تمامی این ضایعات از طریق نمونهبرداری بافتی (هیستوپاتولوژی) تأیید قطعی شده بودند. این مجموعهتست شامل موارد زیر بود:
- ۱۰۰ ضایعه نیازمند پیگیری و عدم ترخیص: شامل ۳۰ مورد ملانوم، ۲۵ مورد کارسینوم سلول بازال، ۲۵ مورد کارسینوم سلول سنگفرشی و ۲۰ مورد کراتوز اکتینیک.
- ۱۰۰ ضایعه بیخطر با قابلیت ترخیص: شامل ۵۰ مورد خال خوشخیم و ۵۰ مورد کراتوز سبورئیک.
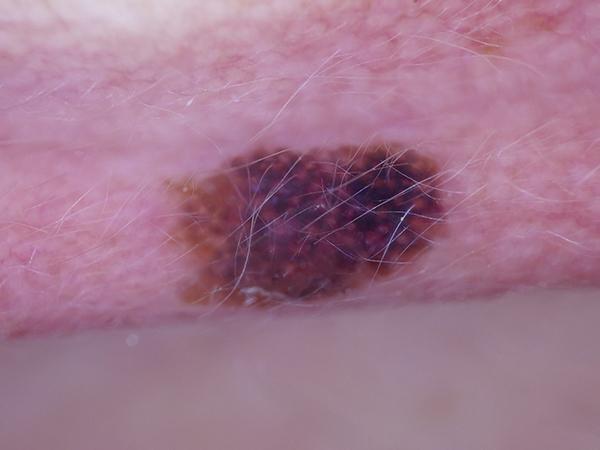
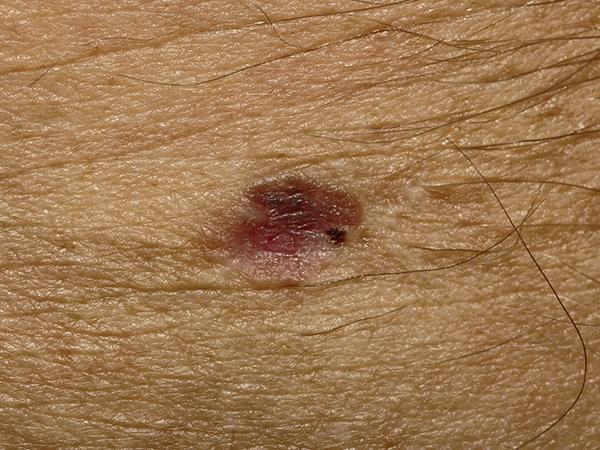
مدلهای زبانی با دریافت دو تصویر از هر ضایعه (یک عکس کلینیکی نمای نزدیک و یک تصویر درموسکوپی گرفته شده با لنز بزرگنمایی نوردار) و بدون هیچ راهنمایی اضافی، موظف شدند محتملترین تشخیص را از میان ۶ گزینه ممکن اعلام کنند و نظر خود را درباره امکان ترخیص بیمار بدهند. در مقابل، مدل CNN (مبتنی بر Inception v3 ساخت ۲۰۱۵) روی دادههای درموسکوپی و کلینیکی تنظیم دقیق (Fine-tune) شده بود، به گونهای که این ۲۰۰ ضایعه آزمایشی هرگز در دادههای آموزشی آن حضور نداشتند.
مقایسه نتایج: وقتی تکنولوژی قدیمی برنده میشود
بر اساس دادههای منتشره در این پژوهش، شبکه عصبی قدیمی Inception v3 توانست در مجموع ۱۲۵ مورد از ۲۰۰ تشخیص را به درستی انجام دهد (دقت ۶۲ درصدی)، در حالی که دو مدل زبانی بزرگ پیشرفته تنها توانستند ۸۴ و ۸۵ مورد (دقت ۴۲ درصدی) را به درستی تشخیص دهند. در جدول زیر خلاصهای از مقایسه آماری این مدلها را مشاهده میکنید:
| شاخص ارزیابی | GPT-6 Astra | Claude Fable 5.1 | CNN (Inception v3) |
|---|---|---|---|
| تشخیص صحیح (از ۲۰۰ مورد) | ۸۴ (۴۲٪) | ۸۵ (۴۲٪) | ۱۲۵ (۶۲٪) |
| تشخیص صحیح در انتخاب اول یا دوم | ۱۳۴ | ۱۳۸ | ۱۷۳ |
| شناخت ملانوم به عنوان انتخاب اول (از ۳۰ مورد) | ۸ | ۱۱ | ۱۳ |
| ضایعات خطرناک حفظشده (از ۱۰۰ مورد) | ۹۷ | ۹۶ | ۷۷ (در آستانه پیشفرض) |
| ضایعات بیخطر ترخیصشده (از ۱۰۰ مورد) | ۳۲ | ۲۲ | ۷۶ (در آستانه پیشفرض) |
نکته جالب اینجاست که مدلهای زبانی تمایل عجیبی به ارائه پاسخهای تکرار شونده داشتند؛ برای نمونه، یکی از مدلها ۷۵ ضایعه را به عنوان کارسینوم سلول بازال برچسب زد، در حالی که تعداد واقعی آنها تنها ۲۵ مورد بود. این خطاهای سیستماتیک نشان میدهد که مدلهای زبانی عمومی برای وظایف تخصصی پزشکی نیازمند کالیبراسیون و آموزشهای تخصصیتر هستند.
چگونه مدل CNN را شخصاً در مرورگر اجرا کنیم؟
یکی از ویژگیهای جالب این پروژه این است که نسخه تنظیمشدهی شبکه عصبی قدیمی (CNN) به اندازه کافی سبک است و بهطور کامل درون مرورگر گوشی یا رایانه و با استفاده از فناوری WebGPU اجرا میشود. هیچ تصویری به سرور خارجی بارگذاری نمیشود و پردازشها محلی هستند.
مراحل تست ابزار توسط کاربر:
- ورود به صفحه رسمی ابزار تحلیل ضایعات پوستی (لینک ورود در انتهای صفحه قرار دارد).
- استفاده از دکمه نمونه تصادفی (Random Sample) برای بارگذاری یکی از تصاویر استاندارد موجود در مجموعه داده ۲۰۰ تایی پژوهش.
- مشاهده پردازش محلی تصاویر کلینیکی و درموسکوپی توسط مدل روی مرورگر.
- دریافت پیشبینی مدل بر اساس ۶ دستهبندی تشخیصی استاندارد پوست.
این فرآیند به محققان و علاقهمندان اجازه میدهد بدون نیاز به نصب هیچ نرمافزار سنگینی، سرعت و عملکرد یک شبکه عصبی کلاسیک را ارزیابی کنند.
محدودیتها، نکات پنهان و اشتباهات رایج
پیش از نتیجهگیری، باید به چند نکته کلیدی و محدودیت مهم در این ارزیابی اشاره کرد:
- اندازه کوچک نمونه: ۲۰۰ ضایعه برای نشان دادن یک الگوی کلی کافی است، اما برای رتبهبندی دقیق نتایج نزدیک به هم یا قطعیت کامل درباره زیرمجموعههای کوچک (مانند ۳۰ مورد ملانوم) به دادههای بیشتری نیاز است.
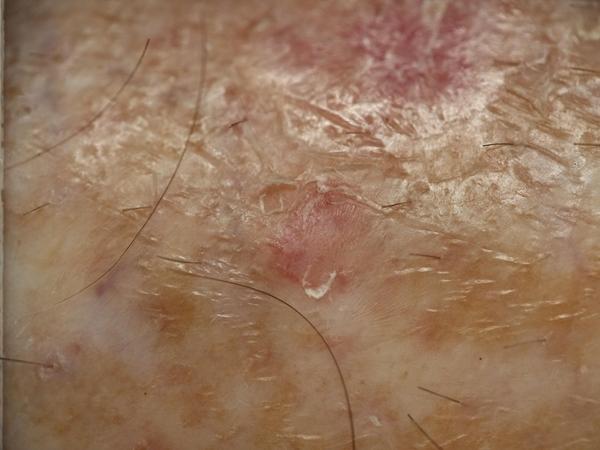
- موارد دشوار بالینی: از آنجا که تمام ضایعات این مجموعه نمونهبرداری (Biopsy) شده بودند، ضایعات معمولی و بسیار ساده در آن کمتر حضور داشتند و به همین دلیل تفکیک آنها برای مدلها دشوارتر بوده است.
- عملکرد مدلهای تجاری رگولاتوری: مدل Inception v3 استفاده شده در این پژوهش یک خط کش پایه (Baseline) است؛ محصولات تجاری پزشکی تأییدشده و رگولهشده که از ترکیب چندین ترنسفورمر تصویر ساخته شدهاند، عملکرد بسیار بهتری دارند.
پرسشهای متداول
آیا این مدل CNN جایگزین تشخیص پزشک متخصص پوست میشود؟
به هیچ عنوان. این مدل تنها یک پروژه تحقیقاتی و پایه است و محصولات تجاری پزشکی نیز صرفاً به عنوان ابزار کمکی در کنار نظر قطعی پزشک استفاده میشوند.
آیا تصاویر آپلود شده در نسخه مرورگر ذخیره میشوند؟
خیر. بر اساس ساختار فنی ابزار که متکی بر WebGPU است، پردازشها به صورت محلی روی دستگاه شما انجام شده و هیچ دادهای به سرور ارسال یا آپلود نمیشود.
دلیل اصلی عملکرد ضعیفتر مدلهای زبانی بزرگ چه بود؟
مدلهای زبانی بزرگ برای درک متن و تولید زبان طراحی شدهاند و بدون تنظیم دقیق (Fine-tuning) تخصصی روی تصاویر درموسکوپی پزشکی، مستعد خطاهای سیستماتیک و تعمیمهای نادرست در تشخیصهای تصویری بالینی هستند.
مجموعه داده MILK10k چیست؟
این یک مجموعه داده عمومی است که در سال ۲۰۲۵ توسط همکاری بینالمللی تصویربرداری پوست منتشر شده و شامل تصاویر باکیفیت کلینیکی و درموسکوپی از ضایعات پوستی است.
جمعبندی
آزمایش مقایسهای انجام شده نشان داد که بزرگ بودن یا جدید بودن یک مدل هوش مصنوعی لزوماً به معنای برتری آن در تمامی حوزههای تخصصی نیست. یک شبکه عصبی ده ساله که بهطور اختصاصی برای تصاویر درموسکوپی پوست بهینهسازی شده بود، توانست عملکردی بهمراتب دقیقتر از مدلهای زبانی پیشرفتهی عمومی ثبت کند. قابلیت اجرای این مدل سبُک روی مرورگر، فرصت مناسبی برای علاقهمندان فراهم میکند تا بدون دغدغههای حریم خصوصی، فناوری یادگیری ماشین در پزشکی را از نزدیک تجربه کنند.



