- اجرای مدلهای 290 میلیارد پارامتری روی کامپیوتر شخصی
- پشتیبانی از سختافزارهای دسکتاپ و کارتهای گرافیک سری RTX
- مدیریت حافظه پویا بدون نیاز به راهاندازی مجدد
فرصت مطالعه ندارید؟ چکیده این مطلب را همینجا گوش دهید:
اجرای مدلهای زبانی بزرگ روی سرورهای ابری هزینههای سنگینی به همراه دارد و بسیاری از توسعهدهندگان ترجیح میدهند برای حفظ حریم خصوصی و کاهش هزینهها، ابزارهای هوش مصنوعی خود را به صورت محلی مدیریت کنند. درست مانند زمان استفاده از ابزارهای پیشرفته مدیریت سیستم یا توسعه مانند معرفی نرمافزار Xtreme Download Manager؛ دانلود منیجر رایگان و اوپنسورس، دسترسی به ابزارهای قدرتمند متنباز آزادی عمل بینظیری به کاربران میدهد. پروژه FreeToken پاسخی انقلابی به همین نیاز است که امکان سرویسدهی مدلهای مقیاس دیتاسنتر را روی دسکتاپ شخصی فراهم میکند.
فریتکن یک موتور سرویسدهی بومی لبه (Edge-Native) از نوع Mixture-of-Experts یا همان MoE است که بهطور اختصاصی برای اجرای مدلهای پیشرفتهی وزن-باز (Open-Weight) روی سختافزارهای شخصی و مصرفی طراحی شده است. این ابزار منابع ناهمگون لبه مانند پردازندههای گرافیکی (GPU)، پردازندههای مرکزی (CPU)، حافظه سیستم و اینترکانکتها را به عنوان یک پلتفرم استنتاج واحد و الاستیک مدیریت میکند.
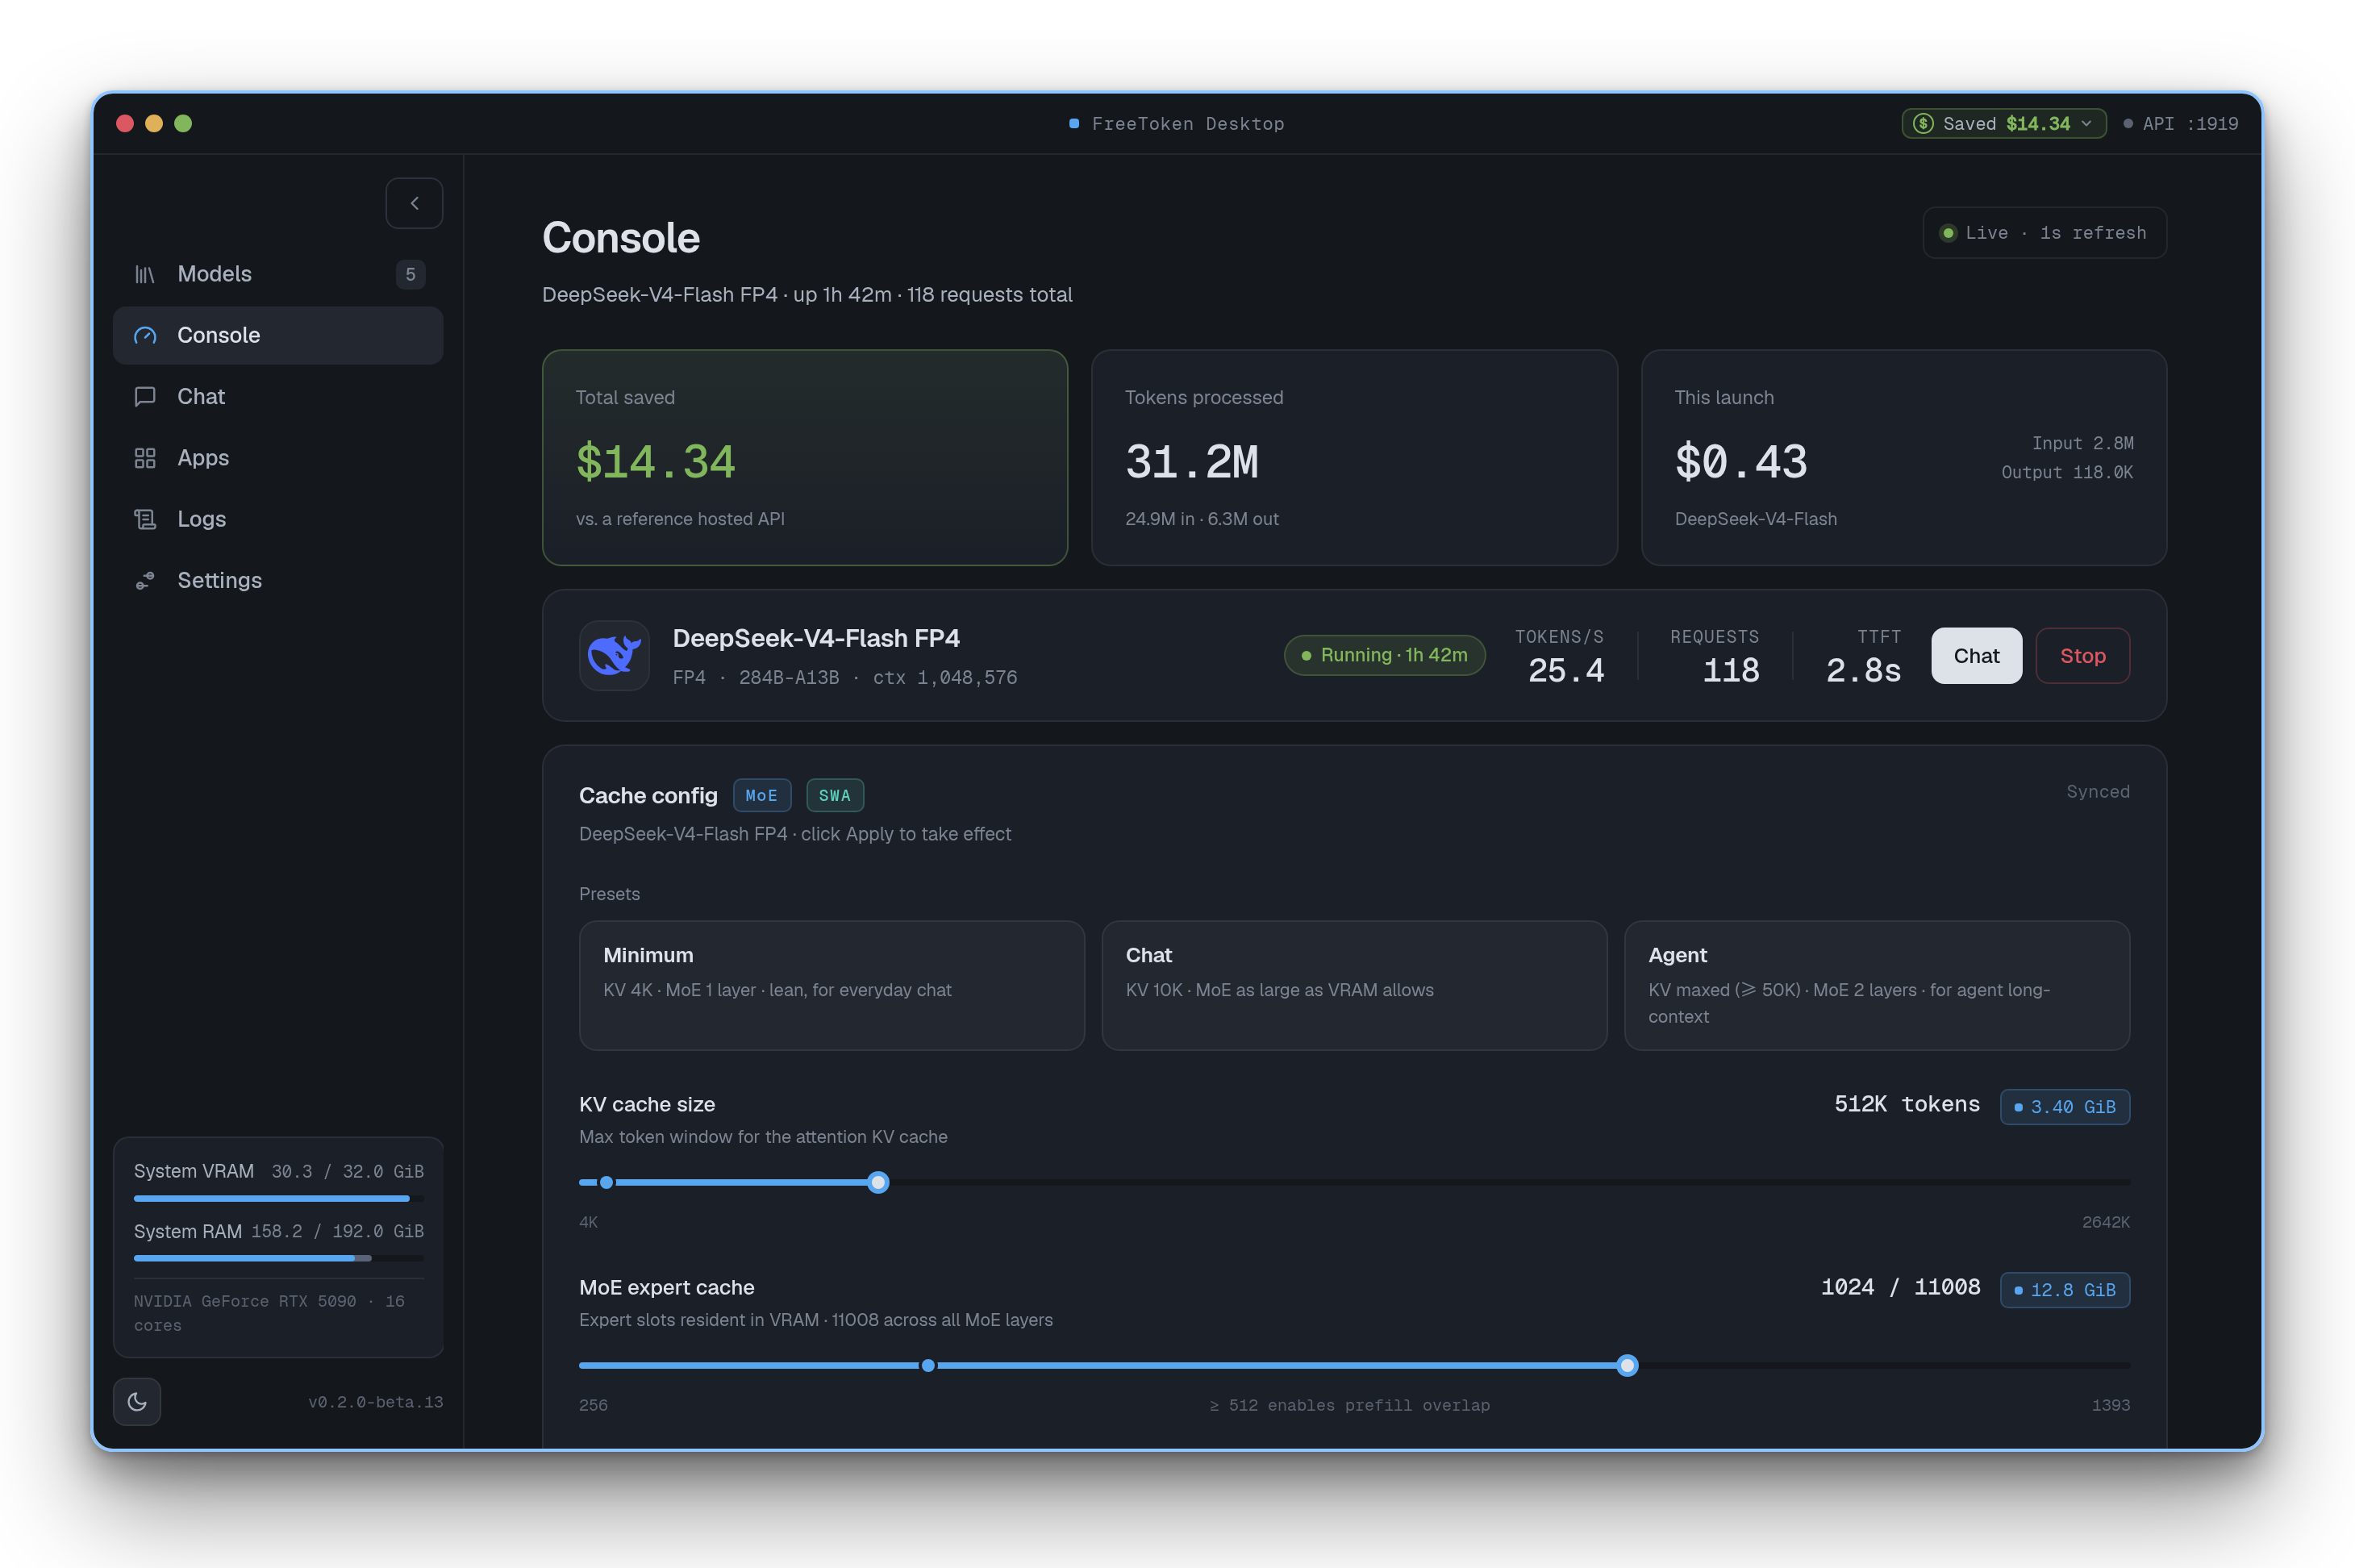
ویژگیها و قابلیتهای کلیدی FreeToken
این موتور قدرتمند با بهرهگیری از معماری مدرن خود، قابلیتهای خیرهکنندهای را در اختیار کاربران قرار میدهد که معمولاً تنها در دیتاسنترها دیده میشوند:
- رانتیم سریع و بومی لبه: ارائه سرویسدهی کارآمد MoE با سیاست هماجرایی پردازنده و گرافیک سازگار با پهنای باند ($q^\star$)، استریم پیشفیل دومرحلهای با بافر دوبل، کشگذاری جهانی LRU برای متخصصان، اجرای سازگار با گراف و فرمت وزن سریع FTW.
- کشینگ آگاه از معنا (Semantic-Aware): دارای نقطهبرگشتهای لنگر معنایی برای وضعیتهای تکرارشونده و کشهای KV که به ویرایشهای متنی ایجنتمحور اجازه میدهد از محاسبات مجدد و اضافی جلوگیری کنند.
- مدیریت حافظه الاستیک: پشتیبانی از تخصیص مجدد پویای VRAM در زمان اجرا میان کشهای متخصص و حافظه KV بدون نیاز به راهاندازی مجدد موتور یا بارگذاری مجدد وزنها.
- پشتیبانی گسترده از اکوسیستم MoE: سازگاری با مدلهای پیشرفته وزن-باز (مانند DeepSeek-V4-Flash، Qwen3.6-35B-A3B و GLM-5.2) در مقیاسهای مختلف پارامتری و فرمتهای کمیسازی (MXFP4، NVFP4، FP8، BF16) به همراه APIهای سازگار با Anthropic و OpenAI.
- سازگاری با سختافزارهای مصرفی: مقیاسپذیری روی لپتاپهای مصرفی، دسکتاپهای گیمینگ و پردازندههای گرافیکی ورکاستیشن با پشتیبانی بومی از سریهای RTX 30، RTX 40 و RTX 50 انویدیا.
جدول مشخصات فنی FreeToken
| ویژگی | مقدار / توضیحات |
|---|---|
| زبان برنامهنویسی | Python |
| مجوز انتشار (License) | Apache-2.0 (متنباز و رایگان) |
| تعداد ستاره در گیتهاب | بیش از ۱۵,۷۰۰ ستاره |
| پلتفرمهای مقصد | ویندوز و لینوکس (دسکتاپ و لپتاپ) |
| وضعیت دسترسی برای ایران | بدون محدودیت فنی داخلی (دسترسی به مخزن گیتهاب آزاد است) |
آموزش نصب و راهاندازی FreeToken
برای نصب و اجرای این موتور قدرتمند، دو روش اصلی پیش روی شماست؛ استفاده از اپلیکیشن دسکتاپ با رابط گرافیکی یا نصب از طریق محیط خط فرمان (CLI) با استفاده از ابزار مدیریت بسته مدرن پایتون.
روش اول: استفاده از اپلیکیشن دسکتاپ
اگر ترجیح میدهید به جای محیط ترمینال با یک رابط گرافیکی تعاملی کار کنید، میتوانید نسخه دسکتاپ FreeToken را برای سیستمعاملهای ویندوز یا لینوکس از وبسایت رسمی پروژه دانلود کنید. این نسخه همهی تنظیمات موتور را بهطور خودکار انجام داده و یک پنل گرافیکی برای اجرای مدلها، چت کردن و تنظیم پارامترها در اختیارتان میگذارد.
روش دوم: نصب از طریق خط فرمان (CLI)
توسعهدهندگان و کاربران حرفهای میتوانند با استفاده از ابزار uv (توصیه شده) یا pip معمولی، موتور را روی سیستم خود نصب کنند. دستور زیر بسته شتابدهنده را نصب میکند:
uv pip install "freetoken[accel]"
توضیح دستور: این دستور پکیج اصلی FreeToken را همراه با وابستگیهای شتابدهنده سختافزاری از طریق مدیر بسته سریع uv نصب میکند تا بالاترین بهرهوری هنگام استنتاج مدل به دست آید.
اگر قصد دارید سورسکد پروژه را کلون کرده و نسخه توسعهدهنده را کامپایل کنید، دستورات زیر را به ترتیب در ترمینال خود اجرا نمایید:
git clone https://github.com/FlashML-org/FreeToken.git && cd FreeToken
uv venv && source .venv/bin/activate
uv pip install -e ".[accel]"
توضیح بخشبهبخش دستورات کامپایل:
git clone ... && cd FreeToken: مخزن پروژه را از گیتهاب دریافت کرده و وارد پوشه مربوطه میشود.uv venv && source .venv/bin/activate: یک محیط مجازی ایزوله برای پایتون میسازد و آن را فعال میکند تا تداخلی با پکیجهای دیگر سیستم ایجاد نشود.uv pip install -e ".[accel]": پروژه را به صورت قابل ویرایش (Editable) همراه با ابزارهای شتابدهنده در محیط مجازی نصب میکند.
پرسشهای متداول
آیا FreeToken واقعاً روی کارتهای گرافیک معمولی گیمینگ قابل اجراست؟
بله، این موتور به گونهای طراحی شده است که با سختافزارهای مصرفی از جمله سریهای مختلف پردازندههای گرافیکی انویدیا (مانند RTX 30، 40 و 50) سازگار بوده و مدلهای حجیم MoE را با سرعت تعاملی بالا اجرا کند.
آیا برای استفاده از این ابزار نیاز به پرداخت هزینه یا لایسنس خاصی است؟
خیر. FreeToken تحت مجوز کاملاً آزاد و متنباز Apache-2.0 منتشر شده و استفاده از آن برای عموم کاربران و توسعهدهندگان رایگان است.
چگونه میتوانم مدلهای پشتیبانیشده توسط این موتور را بررسی کنم؟
پروژه از طیف وسیعی از مدلهای پیشرفته وزن-باز مانند DeepSeek، Qwen و GLM پشتیبانی میکند و مستندات رسمی پروژه در گیتهاب لیست کامل مدلهای سازگار را بهروزرسانی میکند.
جمعبندی
پروژه FreeToken گامی بزرگ در جهت دموکراتیزه کردن هوش مصنوعی پیشرفته است که به کاربران اجازه میدهد مدلهای غولپیکر Mixture-of-Experts با بیش از ۲۹۰ میلیارد پارامتر را مستقیماً روی کامپیوتر شخصی خود اجرا کنند. با پشتیبانی از مدیریت حافظه الاستیک، کشینگ معنایی هوشمند و سازگاری با APIهای استاندارد، این موتور گزینهای بینظیر برای توسعهدهندگانی است که میخواهند زیرساخت هوش مصنوعی محلی، سریع و کاملاً رایگان داشته باشند.



