فرصت مطالعه ندارید؟ چکیده این مطلب را همینجا گوش دهید:
احتمالاً شما هم متوجه شدهاید که در ماههای اخیر، خواندن و درک مطالب نوشته شده توسط مدلهای زبانی بزرگ (LLM) نسبت به گذشته کمی طاقتفرساتر شده است. انگار جملات طولانیتر شدهاند، ساختارهای پیچیدهتری دارند و مغز برای هضم آنها به انرژی بیشتری نیاز دارد. یک پژوهش علمی جدید دقیقاً به سراغ همین معضل رفته و دلایل روانشناختی و زبانی آن را زیر ذرهبین قرار داده است؛ موضوعی که حتی در بررسی ابزارهای پیشرفتهای مثل بررسی ScreenApp؛ ابزار هوش مصنوعی ضبط صفحه، تبدیل صوت و خلاصه جلسات نیز هنگام مواجهه با خروجیهای متنی طولانی به چشم میخورد.
ریشهیابی مشکل در ساختار زبان و روانشناسی شناخت
پژوهشگران در مطالعهای تازه، مجموعهای از ویژگیهای روانزبانشناختی (Psycholinguistic Features) را که مستقیماً با میزان دشواری در پردازش انسانی ارتباط دارند، بررسی کردهاند. مواردی نظیر وابستگیهای سینتکسی طولانی، بندهای موصولی مفعولی و انگرامهای کمبسامد از جمله این موارد هستند. نتایج نشان میدهد که مدلهای هوش مصنوعی این عناصر دشوار را حتی بیشتر از ترجمههای ماشینی رفت و برگشتی در متن به کار میبرند.
مقایسه متون تولیدی با نوشتههای انسانی حاکی از آن است که مدلهای پیشرو و نزدیک به پیشرو (Frontier and Near-frontier Models)، تمایل عجیبی به استفاده از فاعلهای بیجان در کنار افعال جاندار و عبارات کمبسامد دارند. علاوه بر این، در مکالمات روزمره نیز مواردی چون وابستگیهای طویلتر و انباشت اسمها بیشتر دیده میشود که تفاوت معناداری با سبک نگارش انسانها دارد.
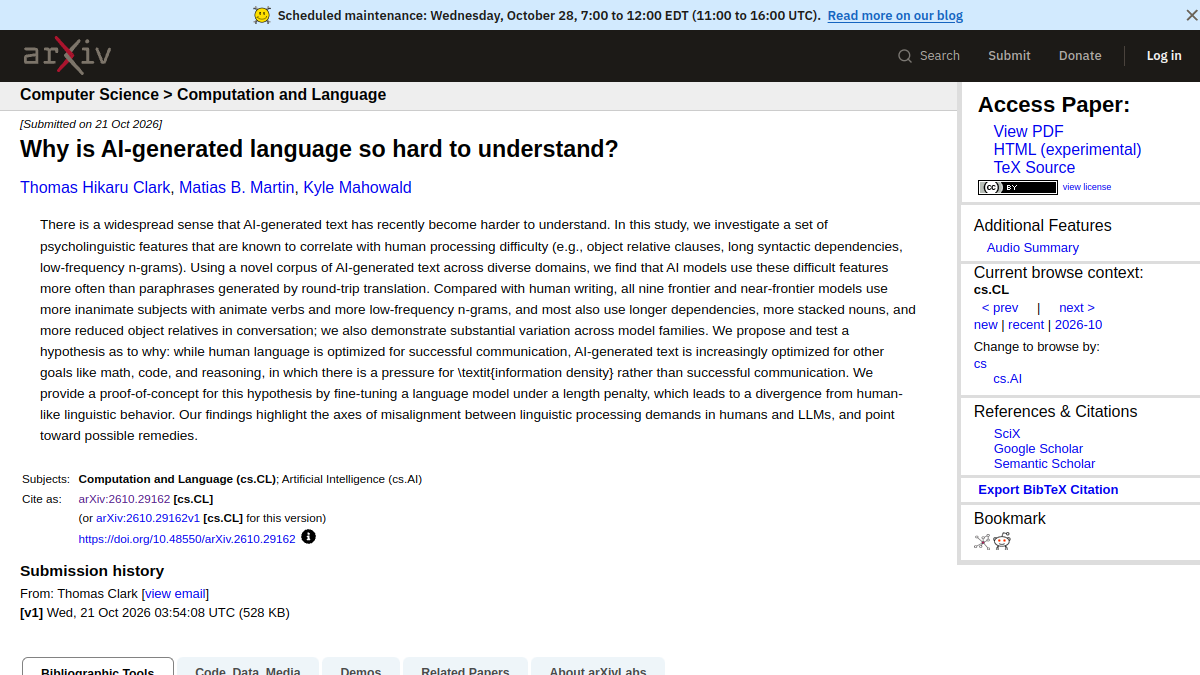
| عنوان پژوهش | چرا زبان تولید شده توسط هوش مصنوعی برای درک سخت است؟ |
|---|---|
| حوزه تخصصی | علوم کامپیوتر > محاسبات و زبان (Computation and Language) |
| تاریخ انتشار | ۲۱ اکتبر ۲۰۲۶ |
| یافته اصلی | اولویتدهی مدلها به «چگالی اطلاعات» به جای «ارتباط موفق» |
| وضعیت دسترسی ایران | آزاد (بدون محدودیت خاصی برای مطالعه مقالات اریکسو) |
چرا هوش مصنوعی اینگونه مینویسد؟ (فرضیه چگالی اطلاعات)
سوال اصلی اینجاست که چرا هوش مصنوعی به سمتی رفته که خروجیاش برای انسانها ناخواناتر به نظر میرسد؟ پاسخ محققان در هدفگذاری این مدلها نهفته است. زبان انسان برای «ارتباط موفق و روان» بهینهسازی شده است؛ در حالی که مدلهای زبانی بزرگ روزبهروز بیشتر برای اهدافی مانند حل مسائل ریاضی، کدنویسی و استدلال منطقی بهینهسازی میشوند.
در حوزههایی مثل کدنویسی و استدلال، فشار شدیدی برای بالا بردن «چگالی اطلاعات» (Information Density) وجود دارد تا بیشترین داده در کمترین فضای ممکن منتقل شود. این فشار ساختاری باعث میشود مدل در تولید متنهای عمومی و انسانی نیز همین رویه را حفظ کند و در نتیجه، رفتاری متفاوت از لحن طبیعی انسان بروز دهد.
آزمایش فرضیه و راهحلهای پیش رو
برای اثبات این فرضیه، پژوهشگران دست به یک آزمایش عملی زدند. آنها یک مدل زبانی را با اعمال جریمه طول (Length Penalty) بهینهسازی و تنظیم دقیق (Fine-tune) کردند. نتیجه این بود که خروجی مدل به وضوح از رفتار زبانی انسان فاصله گرفت و بیشتر در خدمت اهداف فشردهسازی اطلاعات قرار گرفت.
این یافتهها محورهای اصلی عدم تطابق (Misalignment) بین نیازهای پردازش زبانی در انسان و مدلهای هوش مصنوعی را آشکار میکند. شناخت این شکاف، گام نخست برای توسعه روشهایی است که بتواند خروجی هوش مصنوعی را دوباره به روانشناسی شناختی انسان نزدیکتر کند.
ابزارهای مرتبط و مطالعه بیشتر
اگر علاقهمند به پیگیری مقالات تخصصی و ابزارهای مرتبط با این پژوهش هستید، بستر اریکسو ابزارهای کتابشناختی مختلفی را در اختیار پژوهشگران قرار میدهد. برای مثال، ابزارهایی مانند Connected Papers و Litmaps برای کشف مقالات مرتبط و alphaXiv برای بررسی کدهای همراه با مقالات استفاده میشوند. آشنایی با این ابزارها میتواند به شما در درک عمیقتر تحولات هوش مصنوعی کمک کند، همانطور که در بررسی ابزارهای امنیتی و تخصصی دیگر نیز دیدهایم.
پرسشهای متداول
چرا خواندن متنهای تولید شده با هوش مصنوعی گاهی خستهکننده است؟
به این دلیل که مدلهای هوش مصنوعی به جای بهینهسازی متن برای «ارتباط روان انسانی»، روی چگالی اطلاعات، استدلال و کدنویسی تمرکز دارند که ساختار جملات را پیچیدهتر میکند.
آیا این مشکل در تمامی مدلهای هوش مصنوعی به یک اندازه دیده میشود؟
خیر، پژوهش نشان میدهد که بین مدلهای مختلف و خانوادههای گوناگون آنها در میزان استفاده از این ویژگیهای زبانی دشوار، تفاوتهای قابل توجهی وجود دارد.
راه حل پیشنهادی برای اصلاح این رفتار در مدلها چیست؟
شناخت محورهای عدم تطابق و تنظیم دقیق مدلها با در نظر گرفتن الگوهای پردازش شناختی انسان میتواند به تولید متنهای خواناتر کمک کند.
جمعبندی
پژوهش جدید درباره دشواری درک متون هوش مصنوعی به ما یادآوری میکند که پیشرفت فناوری همیشه در همه ابعاد همسو با نیازهای زیستی و شناختی انسان نیست. در حالی که مدلها برای پردازش کدهای پیچیده و استدلالهای سنگین قدرتمندتر میشوند، سبک نگارش آنها نیازمند بازنگری است تا ارتباط بهتری با ذهن انسان برقرار کند. آگاهی از این زوایای پنهان به ما کمک میکند نگاه واقعبینانهتری به خروجی ابزارهای هوش مصنوعی داشته باشیم.



